Vektorová, nebo relační databáze: rozhodujte podle dotazů
 Radovan Ďurčenka·· 3 min čtení
Konkrétní záznam, hledání slov a podobnost obsahu řeší jiné otázky. Jak ověřit, co potřebujete pro vyhledávání nad firemními daty.
Jiná otázka vyžaduje jiný způsob hledání
Dotaz na stav konkrétní objednávky potřebuje aktuální záznam. Hledání návodu vlastními slovy potřebuje relevantní text. Právě tímto rozlišením bych začal debatu o databázi.
Příklady v článku jsou modelové. Nejde o popis konkrétního klientského incidentu ani o výsledky měření výkonu.
Relační data pro přesné odpovědi
Objednávky, faktury, zásoby a platby mají identifikátory a vazby. Když se někdo ptá na objednávku 2026/0042, potřebuje její stav ze systému, který ho spravuje. Podobný dokument není náhradou za tento údaj.
Než měnit databázi, prověřil bych datový model, dotazy a indexy stávajícího řešení. Nasazení AI asistenta samo o sobě migraci nevyžaduje.
Fulltext pro slova a fráze
Název produktu, označení nebo konkrétní fráze mohou být vhodným zadáním pro fulltext. Jeho přínos ověřte na českých dotazech včetně skloňování a pořadí výsledků.
PostgreSQL nabízí vlastní zpracování a hodnocení textového vyhledávání. Jeho výchozí ranking není totéž co BM25; dokumentace PostgreSQL popisuje funkce ts_rank a ts_rank_cd.
Vektory pro podobnost obsahu
Embedding reprezentuje obsah číselným vektorem. Porovnání vektorů pomáhá najít významově blízké pasáže i tehdy, když uživatel použije jiné výrazy.
Podobnost nezaručuje správnost ani aktuálnost. Záleží na modelu, přípravě dokumentů i vyhledávání. Rozšíření pgvector podporuje přesné a přibližné hledání nejbližších vektorů. Přibližný index může zvýšit rychlost za cenu vynechání některých relevantních výsledků.
Modelová situace v zákaznické podpoře
Na otázku „Jak vrátím zboží?“ lze dohledat postup v dokumentaci. Na otázku „Už jste odeslali moji objednávku?“ je třeba ověřit oprávnění a načíst aktuální záznam.
Ve vyhledávání produktů se mohou spojit textová shoda, významová podobnost a přesné filtry. Dostupná velikost nebo cenový limit musí zůstat podmínkou výsledku.
Jak poznat, že vyhledávání funguje
Připravte sadu typických dotazů a očekávaných odpovědí. Vyhodnocujte relevanci, čerstvost údajů, dobu odezvy a přístupová práva. Zařaďte i otázky, pro které dokumenty správnou odpověď neobsahují.
Ukládejte verzi embeddingového modelu a vazbu na zdroj. Nový model nebo jiné dělení textu ověřte odděleně před přepnutím. Aktualizaci a mazání nastavte podle typu obsahu, nikoli podle univerzální doby uchování.
PostgreSQL s pgvector, nebo samostatná služba?
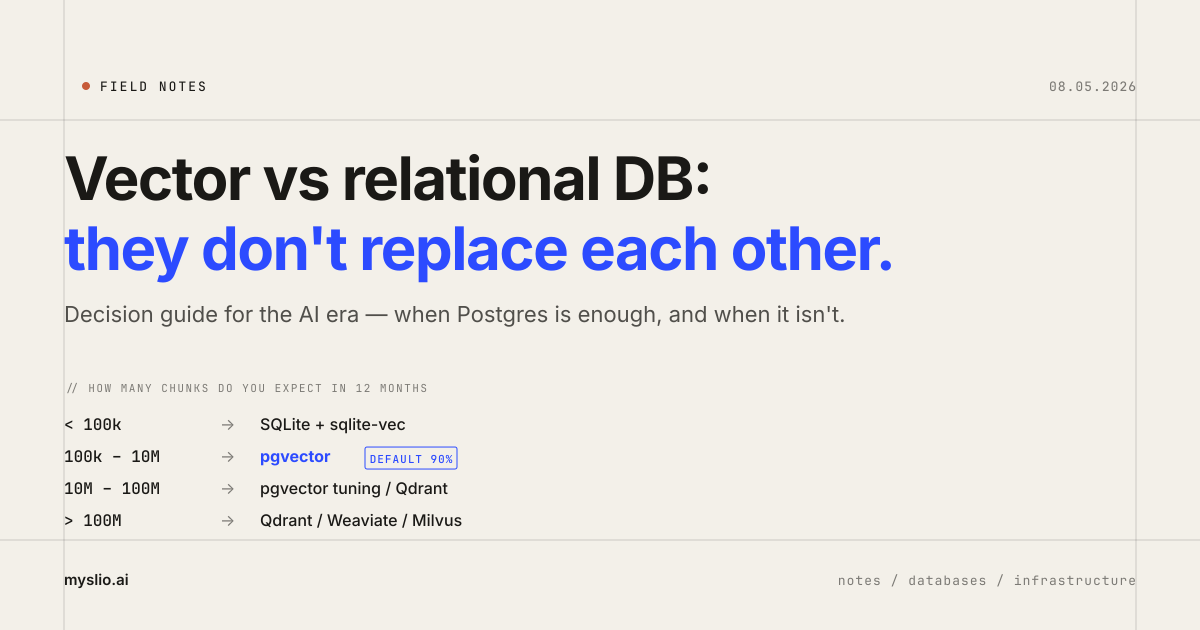
Pokud už PostgreSQL používáte, otestoval bych vektorové hledání ve stejném prostředí. Může zjednodušit správu i propojení s dalšími záznamy.
Oddělený systém posuzujte podle měření. Počet dokumentů není univerzální hranicí pro migraci: záleží také na velikosti vektorů, filtrech, souběhu dotazů, paměti a požadované kvalitě.
Do nákladů patří zálohy, obnova, monitoring a práce týmu. Samotný účet za server nelze srovnávat s celou spravovanou službou bez těchto položek.
S čím začít u vás
- Hledáte konkrétní záznam, slova, nebo významově podobný obsah?
- Kde je aktuální zdroj a kdo k němu má přístup?
- Jakou kvalitu a odezvu potřebujete na vlastních datech?
Další poznámky z praxe
Kdy Shoptet přestává stačit — a kdy ho určitě neměňte
Provozujeme e-shopy na Shoptetu i na vlastním commerce řešení. S růstem firmy často začnou zdržovat procesy po nákupu: předávání objednávek mezi skladem, účetnictvím, platbami a dopravou.
Kdy n8n, kdy Claude Desktop a kdy vlastní AI agent
Praktický postup pro výběr automatizace: od opakovaných úloh přes práci s asistentem až po provoz vlastního agenta.